现代AI口型同步技术是计算机视觉和生成式AI的奇迹。让我们探索它实际上是如何工作的。
挑战
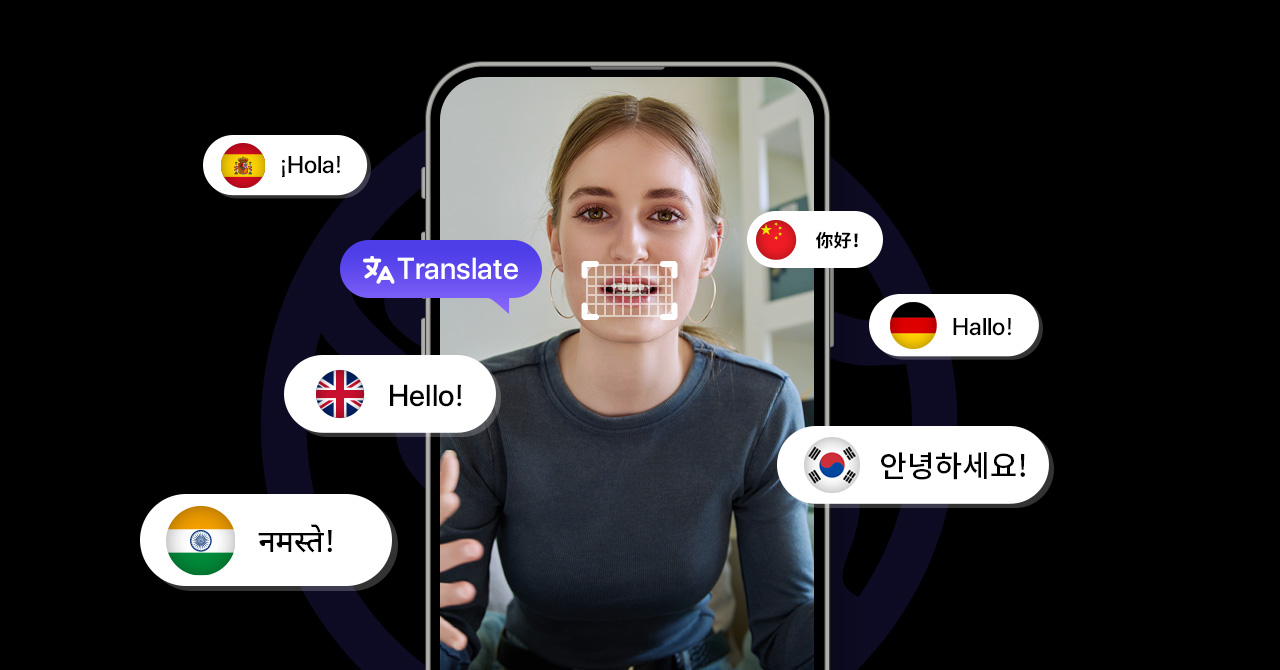
不同的语言使用不同的嘴形(音素)来发声。英语中的「Hello」与西班牙语中的「Hola」产生不同的嘴唇动作。
AI如何解决它
1. 人脸检测和跟踪
AI首先在整个视频中识别和跟踪人脸,创建面部特征点的详细地图。
2. 音素分析
分析新的翻译音频以识别每个音素(不同的声音单元)。每个音素对应特定的嘴形。
3. 帧生成
使用类似于驱动图像生成器的生成式AI模型,系统为每个视频帧创建新的嘴部位置。
4. 无缝融合
修改后的嘴部区域被融合回原始视频,保留其余的脸部、光线和视频质量。
技术栈
现代口型同步系统使用:
- Wav2Lip或类似模型用于音频到嘴唇映射
- **GAN(生成对抗网络)**用于逼真的帧生成
- 超分辨率模型以保持视频质量
为什么Genve.ai脱颖而出
我们专有的模型专门为视频本地化训练,优化:
- 自然的嘴唇动作
- 情感保留
- 处理速度
- 视频质量保持