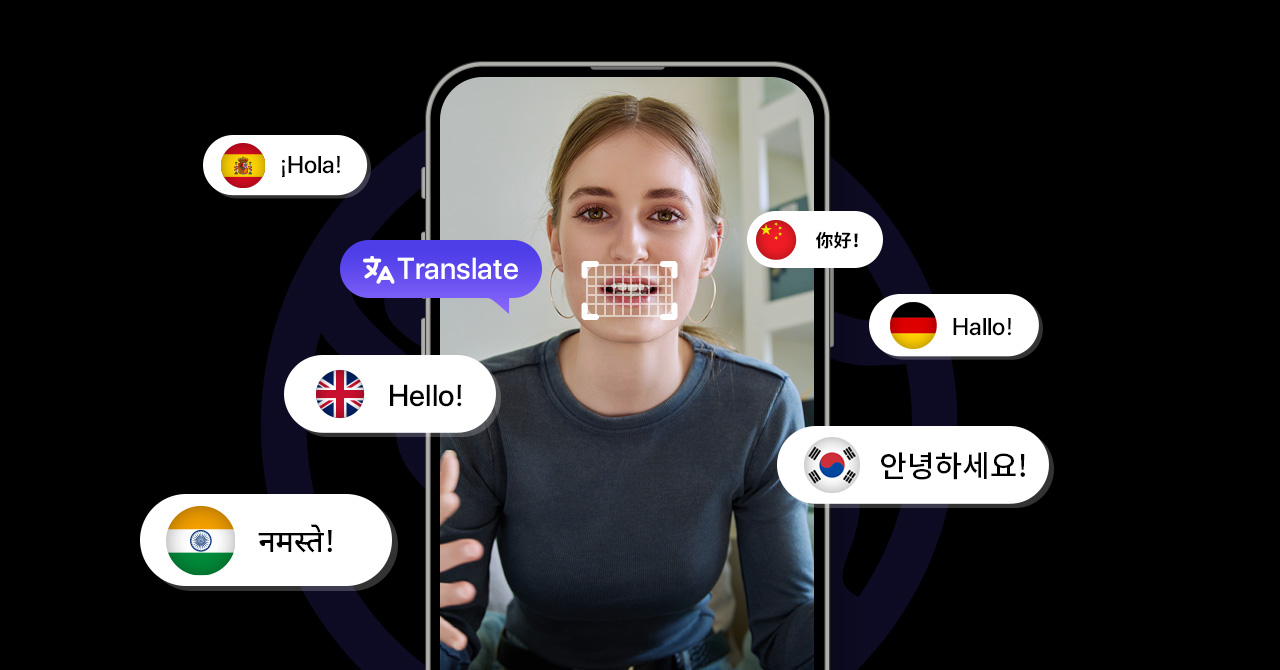
Moderne KI-Lippensync-Technologie ist ein Wunder der Computer Vision und generativen KI. Lassen Sie uns erkunden, wie sie tatsächlich funktioniert.
Die Herausforderung
Verschiedene Sprachen verwenden unterschiedliche Mundformen (Phoneme) für ihre Laute. «Hello» auf Englisch erzeugt andere Lippenbewegungen als «Hola» auf Spanisch.
Wie KI es löst
1. Gesichtserkennung und -verfolgung
Die KI identifiziert und verfolgt zunächst das Gesicht im gesamten Video und erstellt eine detaillierte Karte der Gesichtsmerkmale.
2. Phonem-Analyse
Das neue übersetzte Audio wird analysiert, um jedes Phonem (distinkte Lauteinheit) zu identifizieren. Jedes Phonem entspricht bestimmten Mundformen.
3. Frame-Generierung
Mit generativen KI-Modellen, ähnlich denen, die Bildgeneratoren antreiben, erstellt das System neue Mundpositionen für jeden Videoframe.
4. Nahtloses Blending
Der modifizierte Mundbereich wird zurück in das Originalvideo gemischt, wobei der Rest des Gesichts, die Beleuchtung und die Videoqualität erhalten bleiben.
Der Technologie-Stack
Moderne Lippensync-Systeme verwenden:
- Wav2Lip oder ähnliche Modelle für Audio-zu-Lippen-Mapping
- GANs (Generative Adversarial Networks) für realistische Frame-Generierung
- Super-Resolution-Modelle zur Aufrechterhaltung der Videoqualität
Warum Genve.ai hervorsticht
Unsere proprietären Modelle sind speziell für Video-Lokalisierung trainiert und optimieren für:
- Natürliche Lippenbewegungen
- Emotionsbewahrung
- Verarbeitungsgeschwindigkeit
- Erhaltung der Videoqualität